Kurz gesagt: Für Schäden eines KI-Agenten haftet in der Praxis zuerst der, der ihn betreibt und einsetzt - nicht der Agent und selten der Modellanbieter. Deshalb ist die Haftungsfrage vor allem eine Bau-Frage: Wer Freigaben, Limits und Logs richtig setzt, verhindert den Schaden, statt ihn später zu verhandeln.
KI-Agenten sind seit ein paar Monaten kein Demo-Spielzeug mehr. Sie buchen, bestellen, schreiben Kunden an, ändern Datensätze. Und damit taucht die Frage auf, die in jedem zweiten Projektgespräch kommt: Wer zahlt, wenn das Ding etwas Dummes tut? MIT Technology Review hat sich genau diese Frage angesehen - und die kurze Antwort lautet: Das Recht hat für autonome Agenten noch keine saubere Schublade.
Warum die Haftungsfrage bei KI-Agenten offen ist
Klassische Haftung funktioniert über Zurechnung: Ein Mensch oder ein Unternehmen hat gehandelt, fahrlässig oder vorsätzlich. Ein Agent handelt aber in einer Kette. Das Modell kommt von einem Anbieter, der Agenten-Rahmen von einem zweiten, die Tools und APIs von einem dritten, die Konfiguration vom Umsetzer, der Auftrag vom Unternehmen.
Wenn eine Bestellung doppelt rausgeht oder eine Mail mit falschen Preisen an 400 Kunden, lässt sich schwer sagen, an welcher Stelle der Fehler entstanden ist. Modellanbieter schließen Haftung in ihren Nutzungsbedingungen weitgehend aus. Nach meiner Erfahrung bleibt am Ende der hängen, der den Agenten in Betrieb genommen und die Rechte vergeben hat. Das ist in den meisten Fällen der Auftraggeber.
Was in der Praxis wirklich schiefgeht
Die Horrorszenarien aus Vorträgen sind selten. Real sind banale Dinge:
- Der Agent interpretiert eine unvollständige Anfrage zu großzügig und löst eine Aktion aus, die niemand bestellt hat.
- Ein Retry nach einem Timeout führt die gleiche Aktion zweimal aus - doppelte Rechnung, doppelte Buchung.
- Der Agent bekommt Zugriff auf mehr Daten als nötig und schickt sie an einen externen Dienst.
- Eine Preis- oder Bestandsangabe stammt aus einem veralteten Kontext und wird verbindlich kommuniziert.
Keiner dieser Fälle ist ein Modellproblem. Es sind Architekturprobleme.
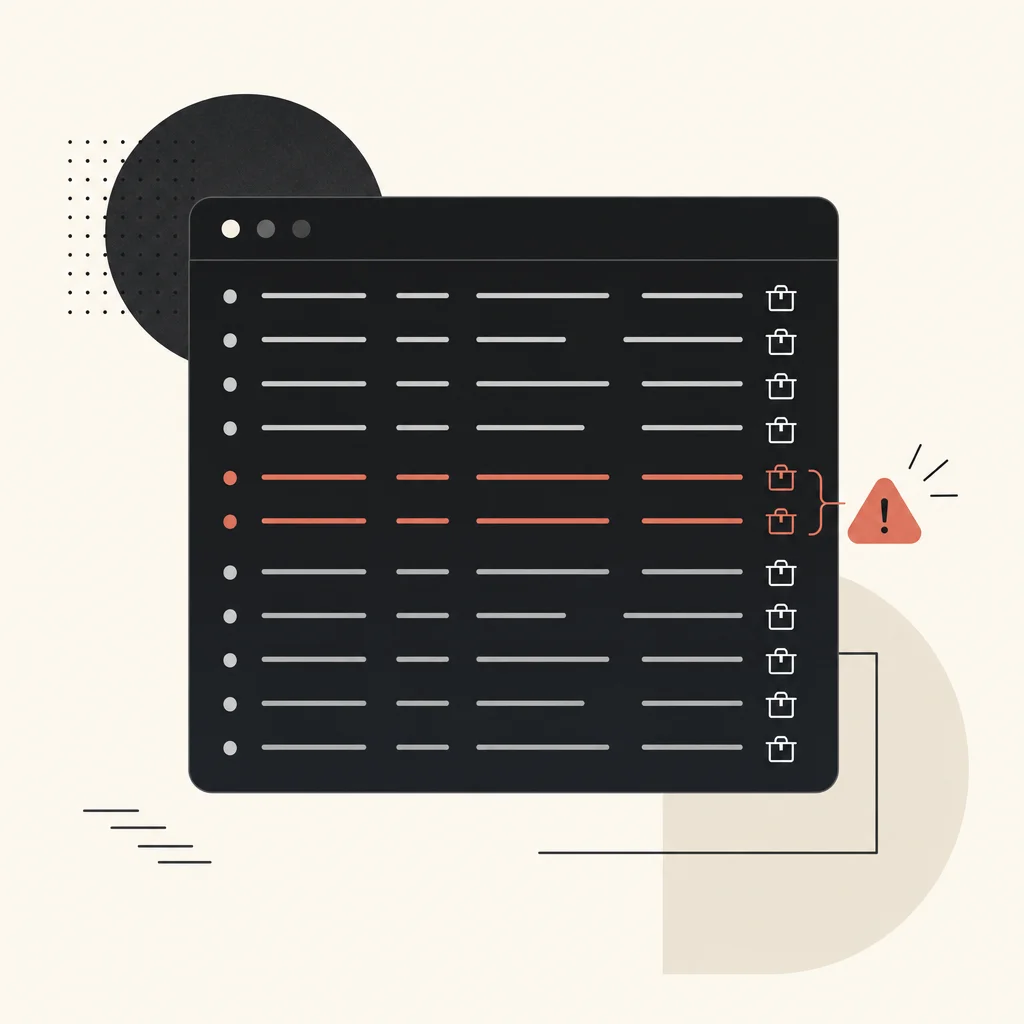
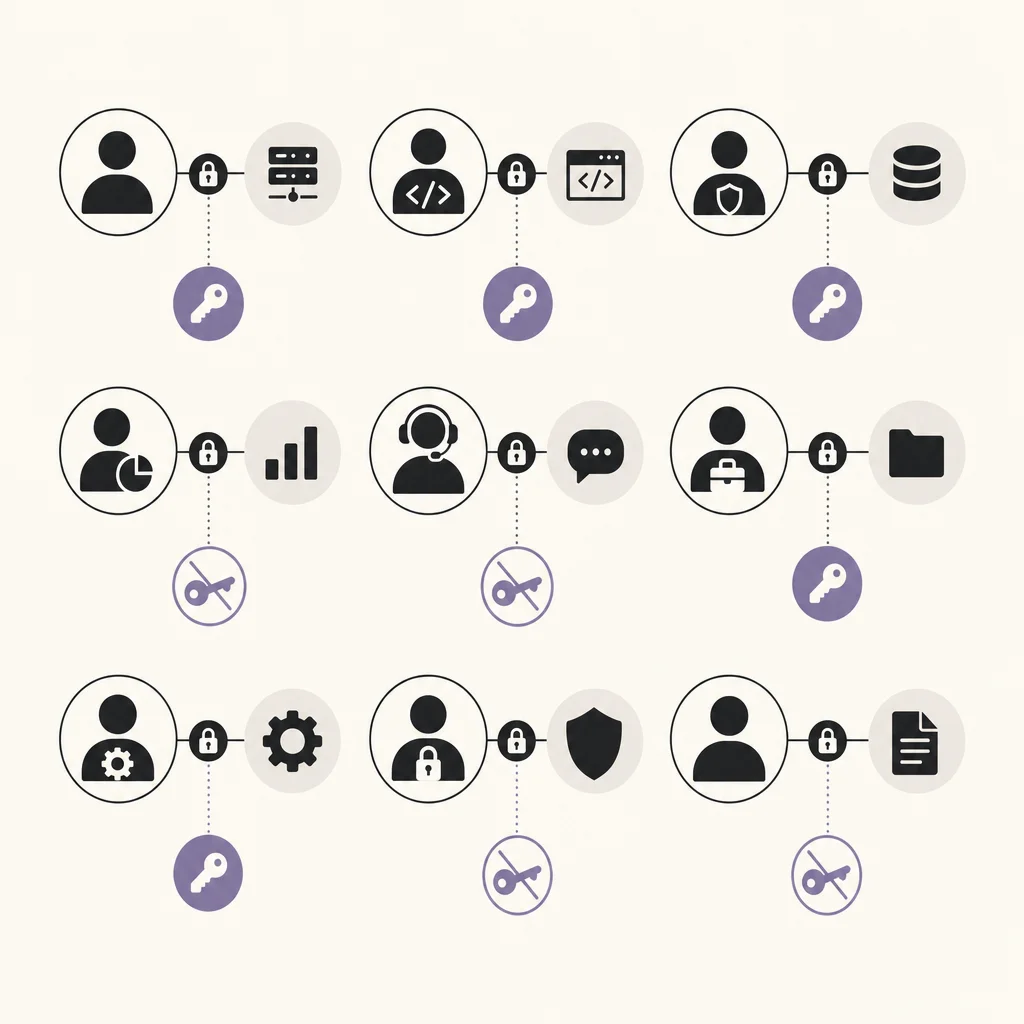
Ein Agent darf alles vorschlagen und fast nichts allein auslösen.
Die Kontrollmechanismen, die in jeden Agenten gehören
Das ist der Teil, den ich in Projekten tatsächlich baue. Nichts davon ist aufwendig, alles davon spart im Ernstfall die Diskussion:
- Freigabe-Gate vor irreversiblen Aktionen. Geld, Verträge, Löschungen, Außenkommunikation: Der Agent schreibt den Entwurf, ein Mensch bestätigt. In n8n ist das ein Human-in-the-Loop-Schritt, keine Raketentechnik.
- Least Privilege bei API-Keys. Eigener Technik-User pro Agent, nur die nötigen Scopes, kein Admin-Token “weil es schneller geht”.
- Harte Limits. Maximale Beträge, maximale Empfängerzahl, maximale Anzahl Aktionen pro Stunde. Wird das Limit gerissen, stoppt der Lauf, statt weiterzumachen.
- Idempotenz. Jede schreibende Aktion bekommt einen eindeutigen Schlüssel. Ein Retry darf nichts verdoppeln.
- Vollständiges Logging. Prompt, Input, Tool-Aufruf, Ergebnis, Zeitstempel. Ohne Log kannst du im Streitfall nicht zeigen, was passiert ist - und genau das brauchst du, um Fahrlässigkeit zu widerlegen.
- Kill-Switch. Ein Schalter, der den Agenten sofort stilllegt, ohne dass jemand im Code sucht.
Wie das in einem echten Projekt aussieht, zeigt die Bewerber-Automatisierung bei Quality Personal: Der Agent bewertet und sortiert vor, die verbindliche Entscheidung bleibt beim Menschen.
Vertraglich: Rollen vorher klären, nicht nachher
Ich bin kein Anwalt, deshalb nur der Umsetzer-Teil. Was in jedem Agenten-Projekt schriftlich stehen sollte:
- Wer betreibt? Läuft der Agent beim Kunden oder bei mir? Betrieb und Verantwortung gehören zusammen.
- Was ist der definierte Handlungsrahmen? Welche Aktionen darf der Agent autonom, welche nur mit Freigabe. Das ist der Kern der Abnahme.
- Wer prüft die Ergebnisse? Ein benannter Verantwortlicher auf Kundenseite, kein “das schaut sich irgendwer an”.
- Was passiert bei Modell-Updates? Ein Anbieter kann das Verhalten über Nacht ändern. Wer testet dann nach, und in welchem Intervall?
- Dokumentation als Nachweis. Konfiguration, Testfälle, Logs. Das ist die Grundlage, mit der du belegst, dass Kontrollen vorhanden waren.
Wenn du Agenten in bestehende Prozesse einbaust, ist dieser Rahmen Teil der Automatisierung selbst - nicht ein Anhang, der danach kommt.
Fazit
Die Rechtslage zu autonomen Agenten wird sich in den nächsten Jahren sortieren. Darauf warten hilft dir nicht. Wer heute einen Agenten mit Schreibrechten in Produktion stellt, trägt das Risiko faktisch selbst. Baue deshalb so, dass ein Fehler teuer aussieht, aber nicht teuer wird: Freigaben vor jeder irreversiblen Aktion, enge Rechte, harte Limits, saubere Logs. Für interne Recherche- und Vorschlags-Agenten kannst du locker bleiben. Sobald Geld, Verträge oder Kundenkommunikation im Spiel sind, gilt: kein autonomer Abschluss ohne Mensch.
FAQ
Wer haftet, wenn ein KI-Agent im Unternehmen einen Schaden verursacht? In der Praxis zuerst das Unternehmen, das den Agenten betreibt und ihm die Rechte gegeben hat. Modellanbieter schließen Haftung in ihren Bedingungen weitgehend aus, und der Agent selbst ist kein Rechtssubjekt. Bei einem Dienstleister hängt es davon ab, was vertraglich als Handlungsrahmen und Abnahme definiert wurde.
Reicht ein Haftungsausschluss im Chatbot aus? Nein. Ein Hinweis wie “Antworten können Fehler enthalten” schützt nicht davor, dass verbindlich wirkende Aussagen gegenüber Kunden zugerechnet werden. Wirksamer sind technische Grenzen: Der Agent gibt keine Preise, Fristen oder Zusagen heraus, die er nicht aus einer geprüften Quelle hat.
Welche Agenten-Aktionen sollten nie ohne Freigabe laufen? Zahlungen und Bestellungen, Vertragszusagen, Löschen oder Überschreiben von Datensätzen, Massen-Kommunikation nach außen und die Weitergabe personenbezogener Daten an Dritte. Alles, was sich nicht mit einem Klick zurückdrehen lässt, braucht einen Menschen davor.
Wie beweise ich im Streitfall, dass der Agent korrekt konfiguriert war? Über Logs und Dokumentation. Protokolliert werden sollten Eingabe, Modellantwort, Tool-Aufruf, Ergebnis und Zeitstempel, dazu die Versionierung der Konfiguration. Ohne diese Spur ist jede Diskussion eine Behauptung gegen eine andere.
Sind KI-Agenten für kleine Unternehmen damit zu riskant? Nein, aber der Einstieg gehört in den lesenden Bereich. Recherche, Vorbereitung, Zusammenfassungen, Entwürfe: dort ist der maximale Schaden ein schlechter Vorschlag. Schreibende und auszahlende Aktionen kommen später dazu, schrittweise und mit Freigabe. Wie sich das für dein Setup aufbauen lässt, klären wir bei der KI-Integration im Vorfeld.